robots.txtとnoindexの使い分け|検索公開を誤らない確認手順
SEO・マーケティング編集:株式会社AO
更新:(判断例・確認手順または説明情報を見直し)
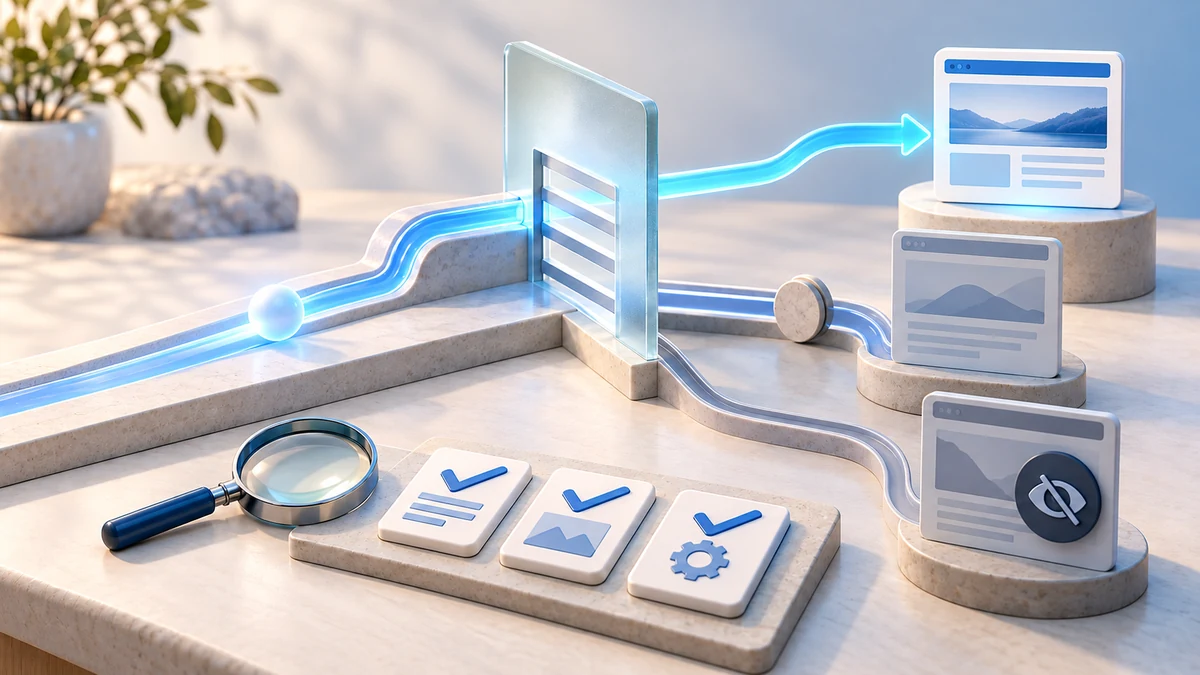
検索結果に出したくないページへrobots.txtを設定すればよい、と考えるのは危険です。robots.txtは主にクロールの制御、noindexは検索結果への登録を防ぐ指定、ログインやパスワード保護は機密情報へのアクセス制限です。目的から逆算して設定し、公開後に実際の応答を検証する手順を整理します。
- robots.txt、noindex、アクセス制限の役割の違い
- ページ種別ごとの判断と実装前チェック
- Search ConsoleとHTTP応答を使った検証手順
目的ごとに手段を選ぶ
Googleは、robots.txtを検索結果からページを隠す仕組みではなく、主にクローラーのアクセスを管理する仕組みと説明しています。外部リンク等からURLが見つかれば、本文をクロールできなくてもURLだけが検索結果へ表示される可能性があります。
| 目的 | 主な手段 | 注意点 |
|---|---|---|
| クロール負荷や不要URLの巡回を抑える | robots.txt | 検索結果からの削除を保証しない |
| 公開ページを検索結果へ出さない | meta robotsのnoindex、またはX-Robots-Tag | クローラーが指定を読める状態にする |
| 機密情報を第三者へ見せない | ログイン、認証、パスワード保護 | robots.txtやnoindexをアクセス制御に使わない |
| 不要ページを完全に廃止する | 削除して404/410、または対応先へ恒久転送 | 内部リンクとサイトマップも更新する |
設定前にURLを棚卸しする
一括設定の前に、対象URL、現在のHTTPステータス、canonical、内部リンク、サイトマップ掲載、検索流入、業務上の公開範囲を一覧にします。似たURLでも、会員ページ、検索結果ページ、テスト環境、重複ページ、PDFでは適切な手段が異なります。
- 対象URLを完全なURLで一覧化する。
- 公開継続、検索非表示、クロール抑制、認証必須、廃止のどれかへ分類する。
- ページがHTMLかPDF等の非HTMLか確認する。
- 内部リンク、XMLサイトマップ、外部流入の有無を確認する。
- 担当者とロールバック方法を決めてから変更する。
実装時の注意点
robots.txtはサイトのルートへ置き、対象ホストとプロトコルごとに確認します。ルールの大文字・小文字、末尾スラッシュ、パラメータ、CMSが生成するURLを実際のパスでテストします。重要なCSSやJavaScriptを誤ってブロックすると、検索エンジンがページを正しく理解できない場合があります。
HTMLページのnoindexはhead内のrobots meta、PDFなどHTML以外はHTTPレスポンスのX-Robots-Tagを検討します。Googleはrobots.txt内のnoindex指定をサポートしていません。CMSの「検索エンジンに表示しない」設定がサイト全体へ及ばないかも確認します。
公開後に検証する
- robots.txtをブラウザーで取得し、想定した内容とHTTP 200を確認する。
- 対象URLのHTTPステータス、robots meta、X-Robots-Tagを確認する。
- Search ConsoleのURL検査でクロール可否と取得されたHTMLを確認する。
- 公開対象ページのCSS、JavaScript、画像が誤ってブロックされていないか確認する。
- サイトマップと内部リンクが方針に一致しているか再確認する。
- 変更日、理由、対象パターン、確認結果を台帳へ残す。
運用チェックリスト
- 目的をクロール制御、検索非表示、アクセス制限、廃止に分けた
- 対象URLとパターンを本番URLで確認した
- robots.txtを機密情報の保護に使っていない
- noindex対象をrobots.txtで同時にブロックしていない
- 非HTMLファイルはX-Robots-Tagを検討した
- 重要なCSS・JavaScript・画像を誤ってブロックしていない
- 内部リンクとサイトマップが方針に一致している
- Search ConsoleのURL検査で実際の取得結果を確認した
- 変更前バックアップとロールバック手順がある
- 変更理由と確認日を運用台帳へ記録した
よくある質問
robots.txtでDisallowすれば検索結果から消えますか?
保証されません。外部リンク等からURLが見つかると、内容をクロールせずURLだけが表示される可能性があります。検索結果へ出さない目的ならnoindexをクローラーが読める状態で設定するか、機密情報なら認証で保護します。
noindexとrobots.txtを両方設定すると確実ですか?
逆効果になる場合があります。robots.txtでクロールを止めると、Googlebotがページ内またはHTTPヘッダーのnoindexを確認できません。
社内資料のPDFはnoindexで十分ですか?
機密情報なら十分ではありません。noindexは検索表示の制御でありアクセス制限ではないため、認証された利用者だけが取得できる場所で管理します。
参考にした公式情報
- Google Search Central:robots.txtの概要
- Google Search Central:noindexでインデックス登録をブロックする
- Google Search Central:robots metaタグとX-Robots-Tag
- Google Search Central:検索で共有する内容を制御する
公式情報の確認日:2026年10月30日。検索エンジンやCMSにより挙動が異なるため、本番変更後は実際の応答と管理画面で確認してください。